AI Judge 正在成为复杂 Agent 系统的基础设施。它能够读取任务要求、运行产物和操作轨迹,再按照 rubric 给出分项判断与最终分数。但在真实生产环境中,“换一个更强的模型”通常不足以解决评分不稳定:输入如何组织、证据如何返回、rubric 如何分批,以及最终分数如何聚合,都会改变结果。
我们在同一套冻结材料和人工裁决的 Golden 标准上,系统比较了四类设计选择。研究的重点不是哪种方案给分更高,而是哪种方案更接近标准答案、更容易复核,并在成本上可接受。
Executive Summary|结论摘要
- 更高的推理强度没有带来稳定收益。 GPT-5.6-sol medium 的最终分数误差为 10.29,xhigh 为 10.65;后者没有表现出可靠优势。生产系统不应默认把更高 effort 当作准确率升级。
- Rubric 分批是最有效的准确率杠杆,但存在明确成本。 每批 1 条时误差最低,为 6.21,但调用量约为一次处理全部 rubric 的 36.1 倍;每批 10 条将误差降到 7.03,调用量约为 4.0 倍,形成更可行的生产折中。
- 证据约束改善的是可审计性,而不是自动改善准确率。 强制返回证据后,证据覆盖率从 12.0% 提升至 100%,位置可解析率达到 99.7%;但先抽取证据、再独立评分会损失上下文,criterion 误差上升到 0.165,pass/fail 翻转率达到 13.83%。
- 聚合应保持确定性。 固定公式的最终分数误差为 10.29;LLM 聚合的误差为 11.76,并增加约 94 秒延迟。让 LLM 只生成解释可以保持机器分数一致,但仍增加约 110 秒延迟。
综合准确性、审计能力和运行开销,当前证据支持的默认配置是:
GPT-5.6-sol medium + 每批 10 条 rubric + 在需要审计时强制返回证据 + 固定、版本化的分数聚合。
这不是对所有任务都成立的永久最优解,而是一套可以被复算、被回归测试,也能随风险等级调整的工程基线。
先建立“准确”的参照系
如果一个 Judge 从 80 分降到 70 分,我们无法仅凭分数方向判断它是变准了,还是变得过度严格。可靠评测必须先有独立参照:对同一份任务产物和同一套 rubric,在 criterion 层确定人工裁决后的标准判断,再通过固定公式得到最终标准分数。本文将这套参照称为 Golden。
Golden 的构建不是把多个模型的多数票直接当作答案。多次独立评分的一致结果只用于初筛;分歧项、边界项、证据不足项和 hard-gate 项按照冻结的审核规则进行来源核查与裁决,形成 criterion-level Golden,再由固定公式聚合为任务级 Golden 分数。
核心准确率指标是平均绝对误差(Mean Absolute Error,MAE):对每个评分单元计算 Judge 分数与 Golden 分数之差的绝对值,再取平均。它可以直接理解为“Judge 平均偏离标准答案多少分”。例如,两个 Golden 分数分别为 80 和 70,Judge 给出 86 和 66,绝对误差分别为 6 和 4,MAE 为 5。MAE 越低,整体越接近 Golden。
MAE 不保留高估或低估的方向,因此分析还同时观察 bias、pass/fail 翻转和 hard-gate error。这样可以避免“高估与低估相互抵消后看起来没有偏差”的假象。
这批任务的判分负荷有多大
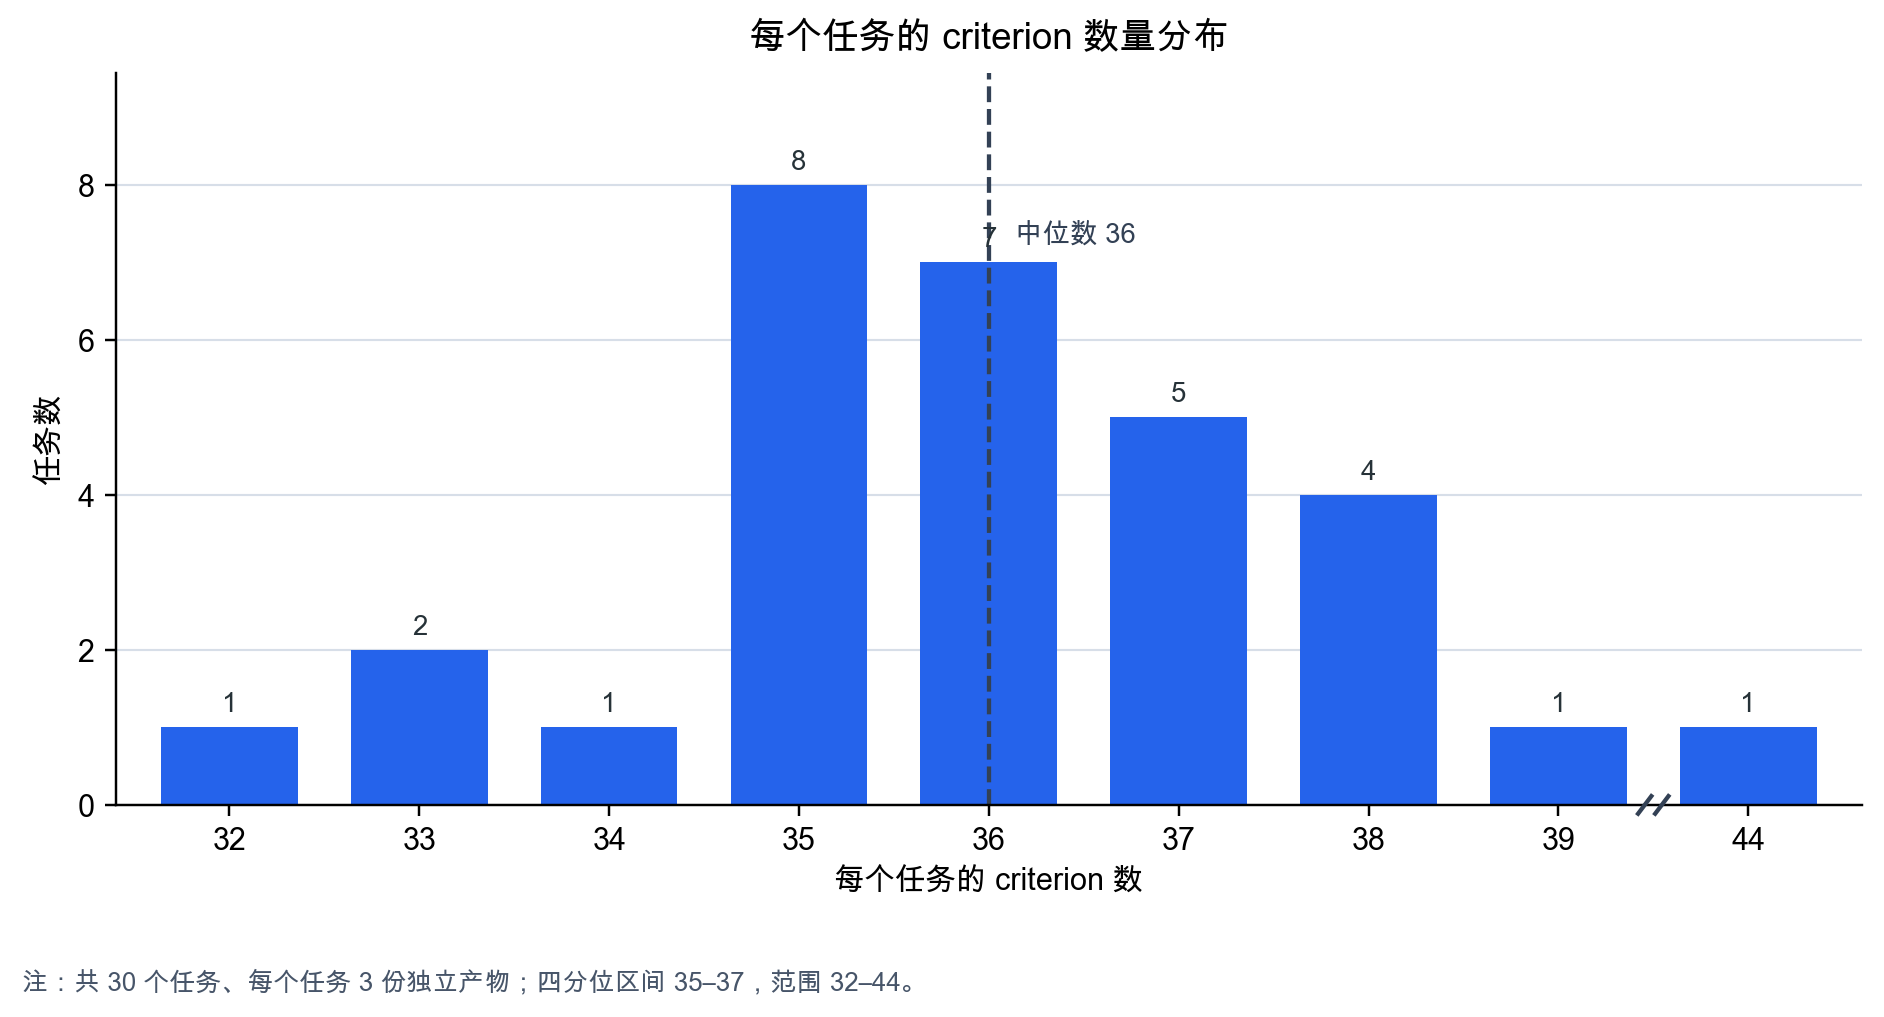
研究由一组复杂任务及其独立产物构成。为避免用任务总量替代对任务难度的描述,我们重点报告每个任务实际需要处理的 rubric 与证据负荷分布。
单个任务的 criterion 数量中位数为 36 条,四分位区间为 35–37 条,整体范围为 32–44 条。其中 hard-gate criterion 的中位数为 6 条,四分位区间为 5–7 条。这意味着 full-rubric Judge 并不是在处理几条简短要求,而是要在一次上下文中同时维护数十条判分锚点、证据位置和 gate 关系。
如果把 Golden 中每个可定位的 evidence locator 视作一次证据引用,那么每份任务产物的引用数中位数约为 80 条,四分位区间为 67–92 条,范围为 51–136 条。这里统计的是审计定位引用,而不是论文参考文献条目;它更接近 Judge 实际需要检索和核对的证据负荷。
强模型承担开放式评测已经有充分实践基础,例如 MT-Bench 与 Chatbot Arena(Zheng 等,2023)以及 G-Eval(Liu 等,2023)。与此同时,既有研究也记录了公平性问题(Wang 等,2024)、位置偏差(Shi 等,2025)和上下文不稳定(Xu 等,2025)。因此,我们把模型视为评测系统中的一个组件,而不是准确性的唯一来源。
模型能力不是当前系统的主要瓶颈
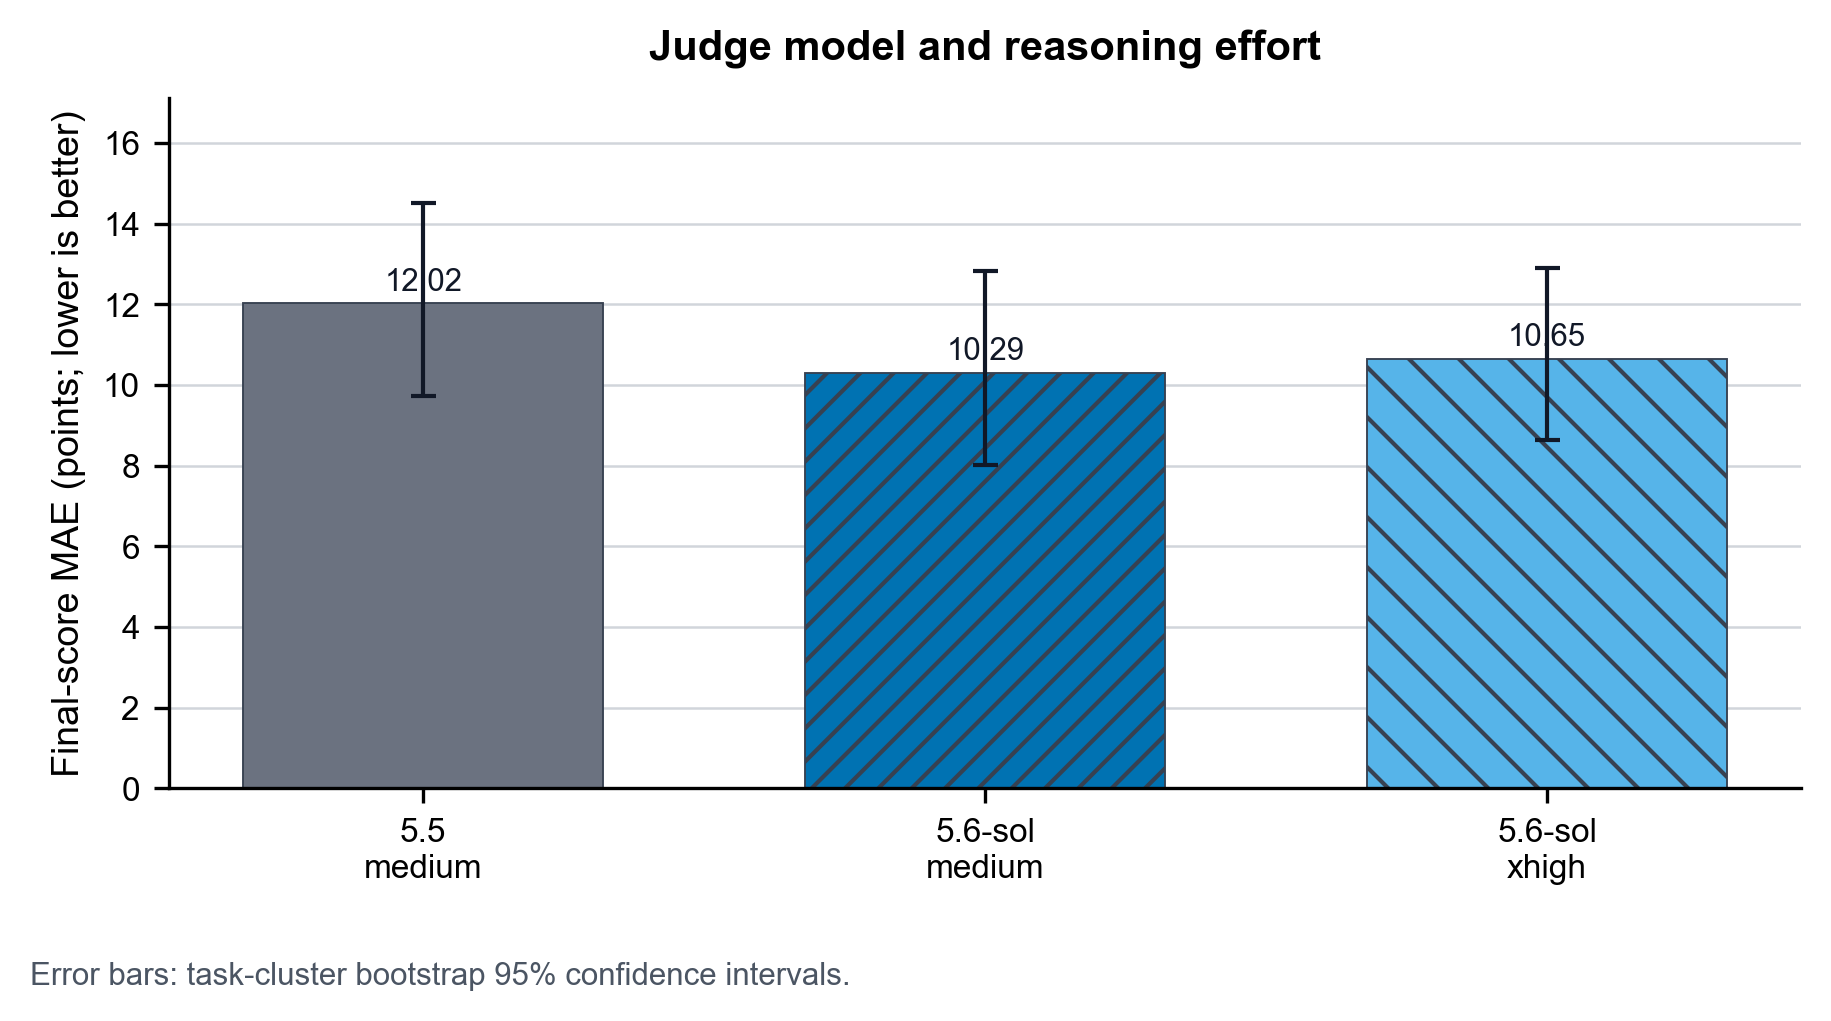
在任务、产物、rubric 和评分流程保持一致时,GPT-5.6-sol medium 的最终分数 MAE 为 10.29,xhigh 为 10.65。xhigh 在个别 criterion 指标上略有改善,但在最终分数误差、正向偏差和 hard-gate error 上均未形成一致优势,配对统计检验也没有支持“更高 effort 稳定更准”的结论。
这个结果提示,当前误差更可能来自评分锚点、长上下文干扰和 rubric 之间的竞争,而不是单纯的推理预算不足。提高 effort 会增加计算,却不会自动改变输入结构或判分规则。对于生产系统,更稳妥的做法是将 medium 作为默认配置,并要求任何 effort 升级先通过同一 Golden 回归集的配对验证。
Rubric 分批形成了清晰的准确率—成本前沿
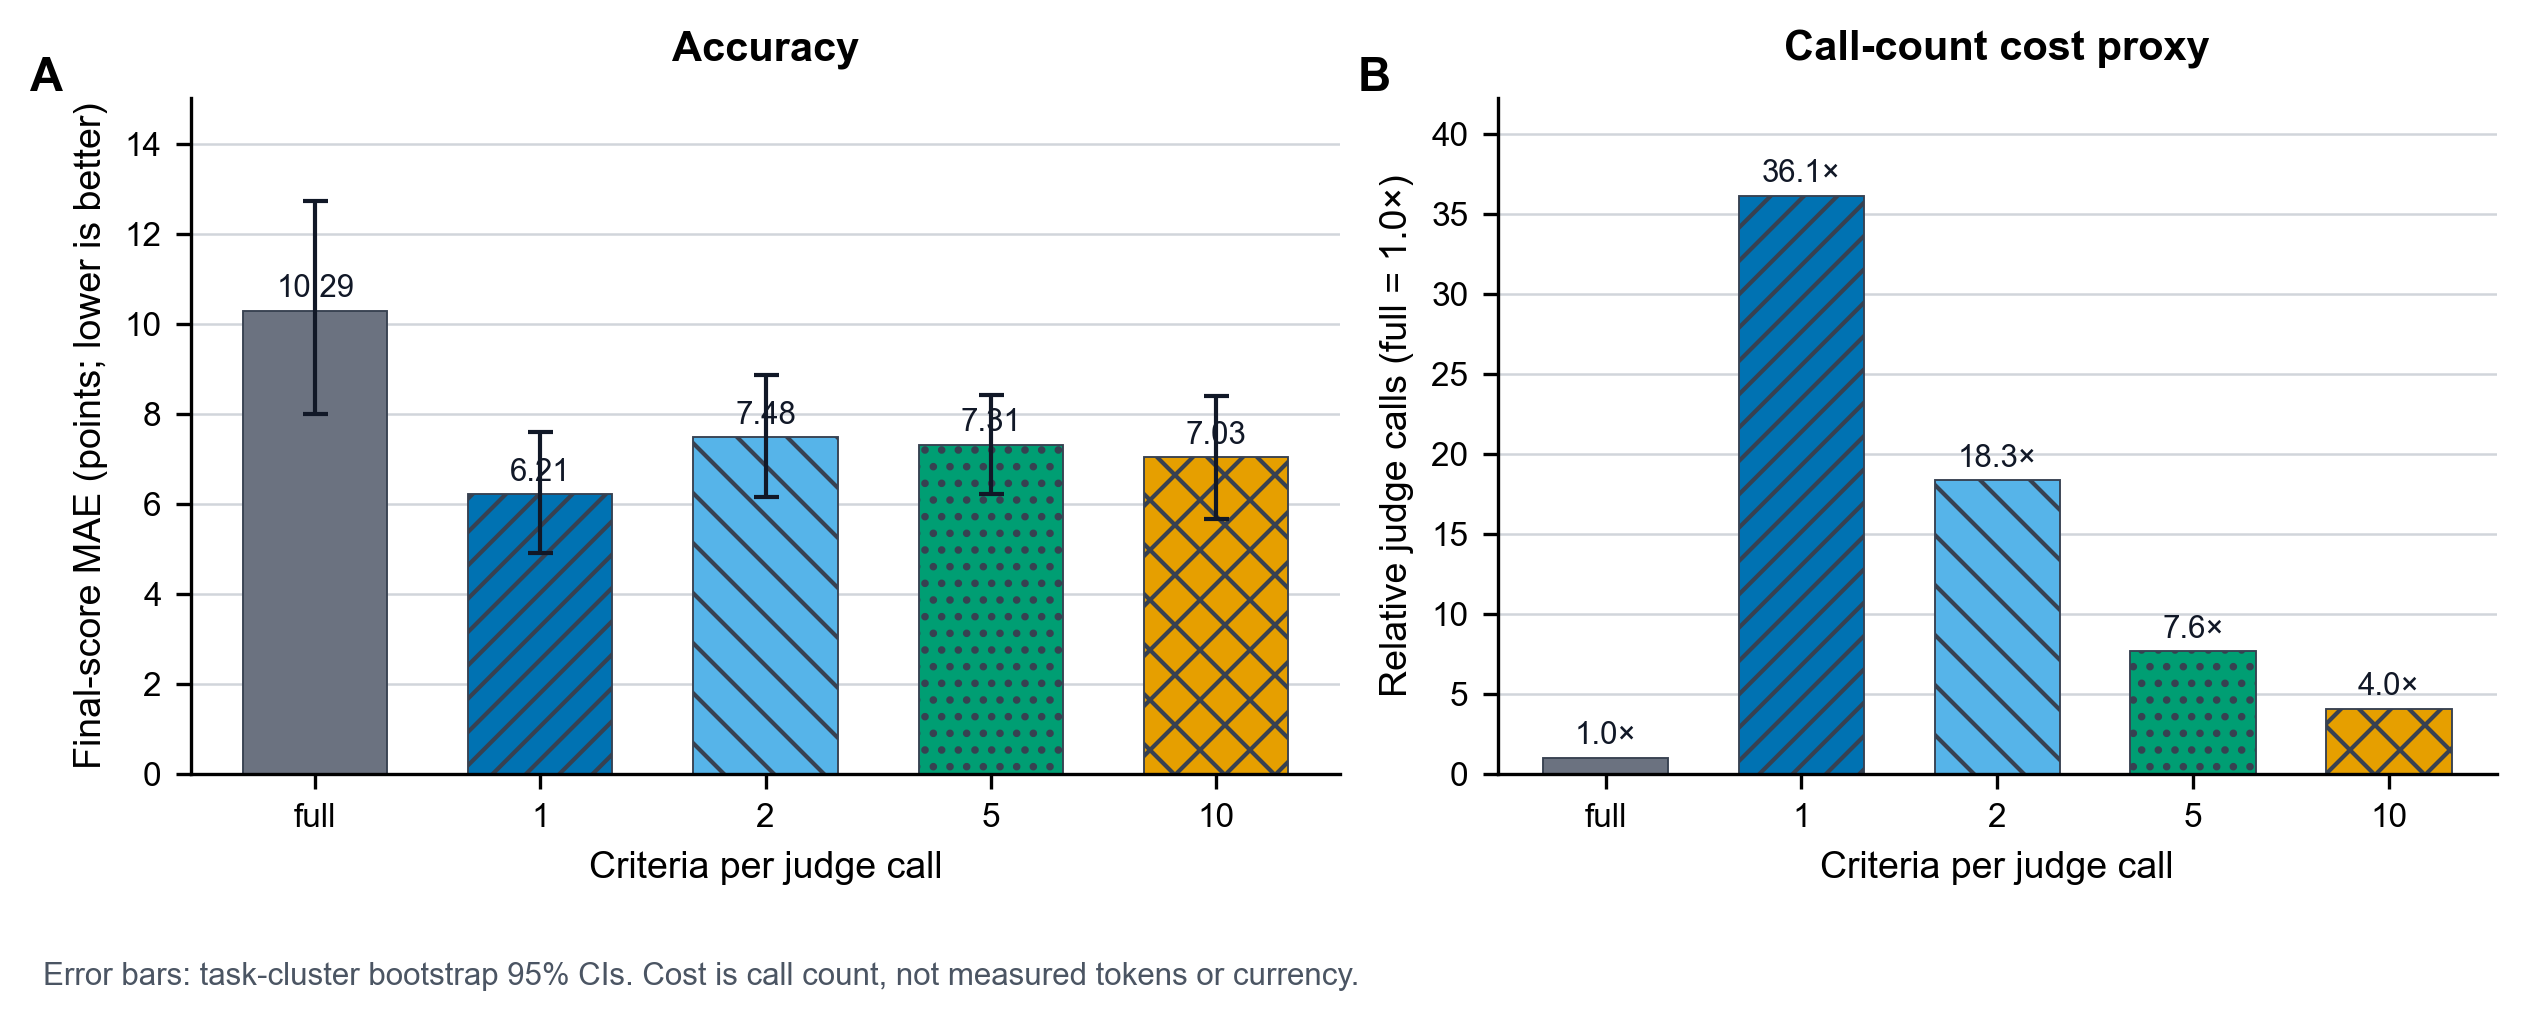
一次向 Judge 提供全部 rubric 时,最终分数 MAE 为 10.29。将每批缩小到 1 条后,MAE 降至 6.21,并且在多重比较校正后仍然显著;代价是调用量约为完整批次的 36.1 倍。
每批 10 条提供了更均衡的选择:MAE 降至 7.03,调用量约为完整批次的 4.0 倍。它没有达到最细粒度的绝对最低误差,但获得了大部分准确率收益,同时避免调用量极端膨胀。
分批有效,说明同一上下文中 criterion 数量本身就是评测变量。过长的 rubric 会引入注意力稀释、判分标准相互干扰和宽松通过。工程上应把 batch size 作为可配置、可回归的系统参数:高风险离线评测可以用每批 1 条换取准确率;常规生产更适合从每批 10 条起步。
这里的成本采用调用量代理:在模型、材料和评测目标保持一致时,用相对调用次数描述不同 batch size 的计算开销。它适合比较方案之间的资源量级,不直接等同于最终账单金额。
证据约束提升可审计性,但两阶段链路会损失信息
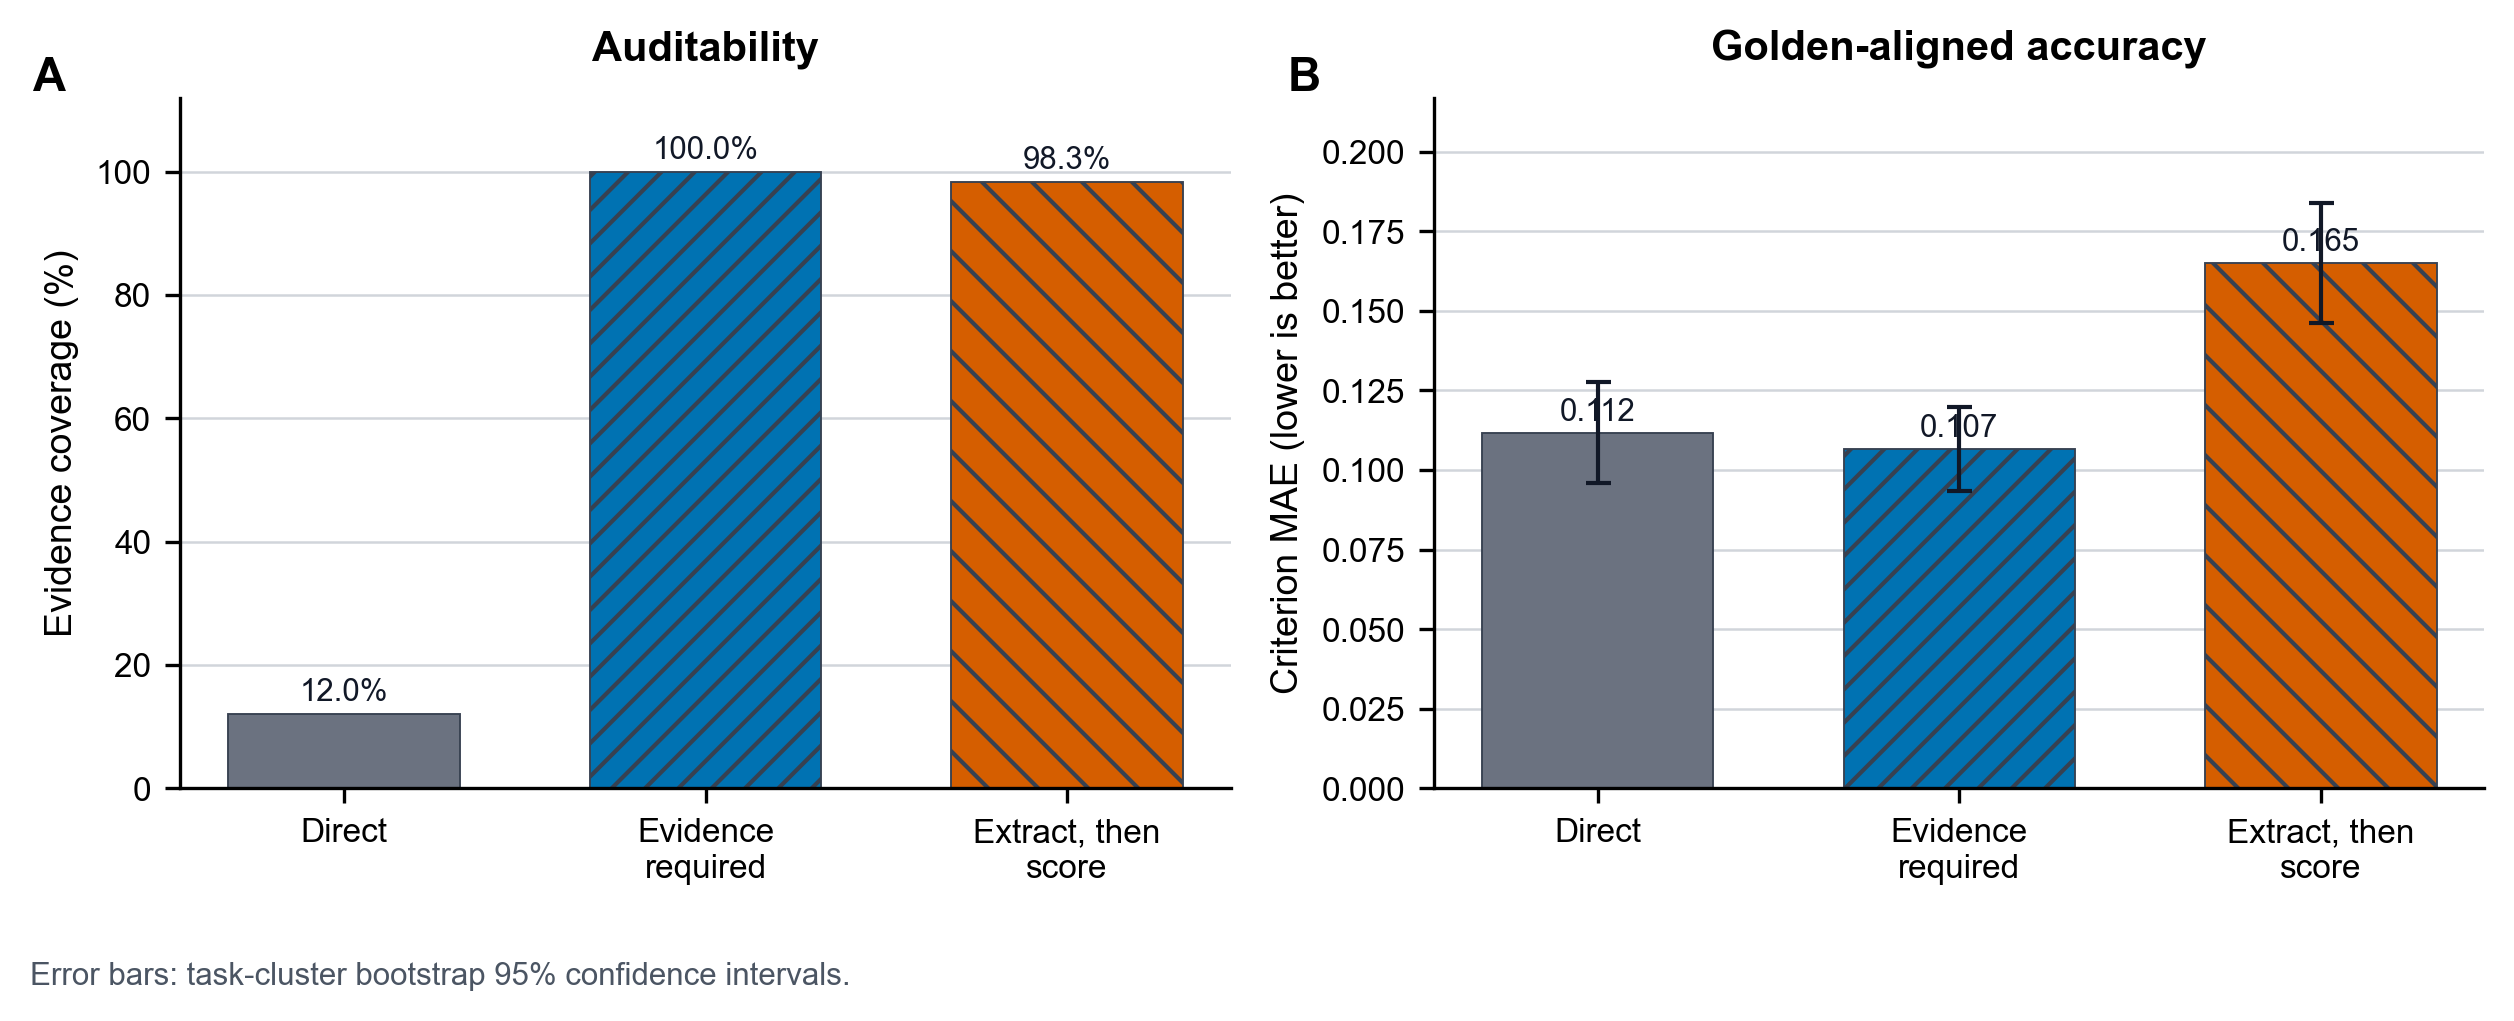
我们比较了三种路径:直接读取材料并评分;要求每条 rubric 同时返回可定位证据;先生成独立 evidence ledger,再只依据 ledger 评分。
强制证据将 evidence coverage 从 12.0% 提升至 100%,证据位置可解析率达到 99.7%。这类改进不会直接体现在最终分数里,却显著提高了复核、申诉处理和错误定位的效率。对于需要审计链路的产品,证据是独立于准确率之外的重要质量维度。
但“先抽证据、再评分”并没有获得更高准确率:criterion MAE 上升至 0.165,pass/fail 翻转率达到 13.83%。独立 ledger 本质上是对原始材料的一次有损压缩;如果抽取阶段遗漏负证据、跨文件关系或必要上下文,评分阶段无法恢复已经丢失的信息。
因此,证据约束更适合作为评分输出契约:Judge 仍然读取完整材料,在给出判断的同时返回证据位置和摘要。只有当独立证据抽取的召回率经过专门验证后,才应将其升级为评分前置层。
聚合是计算步骤,不是第二次判断
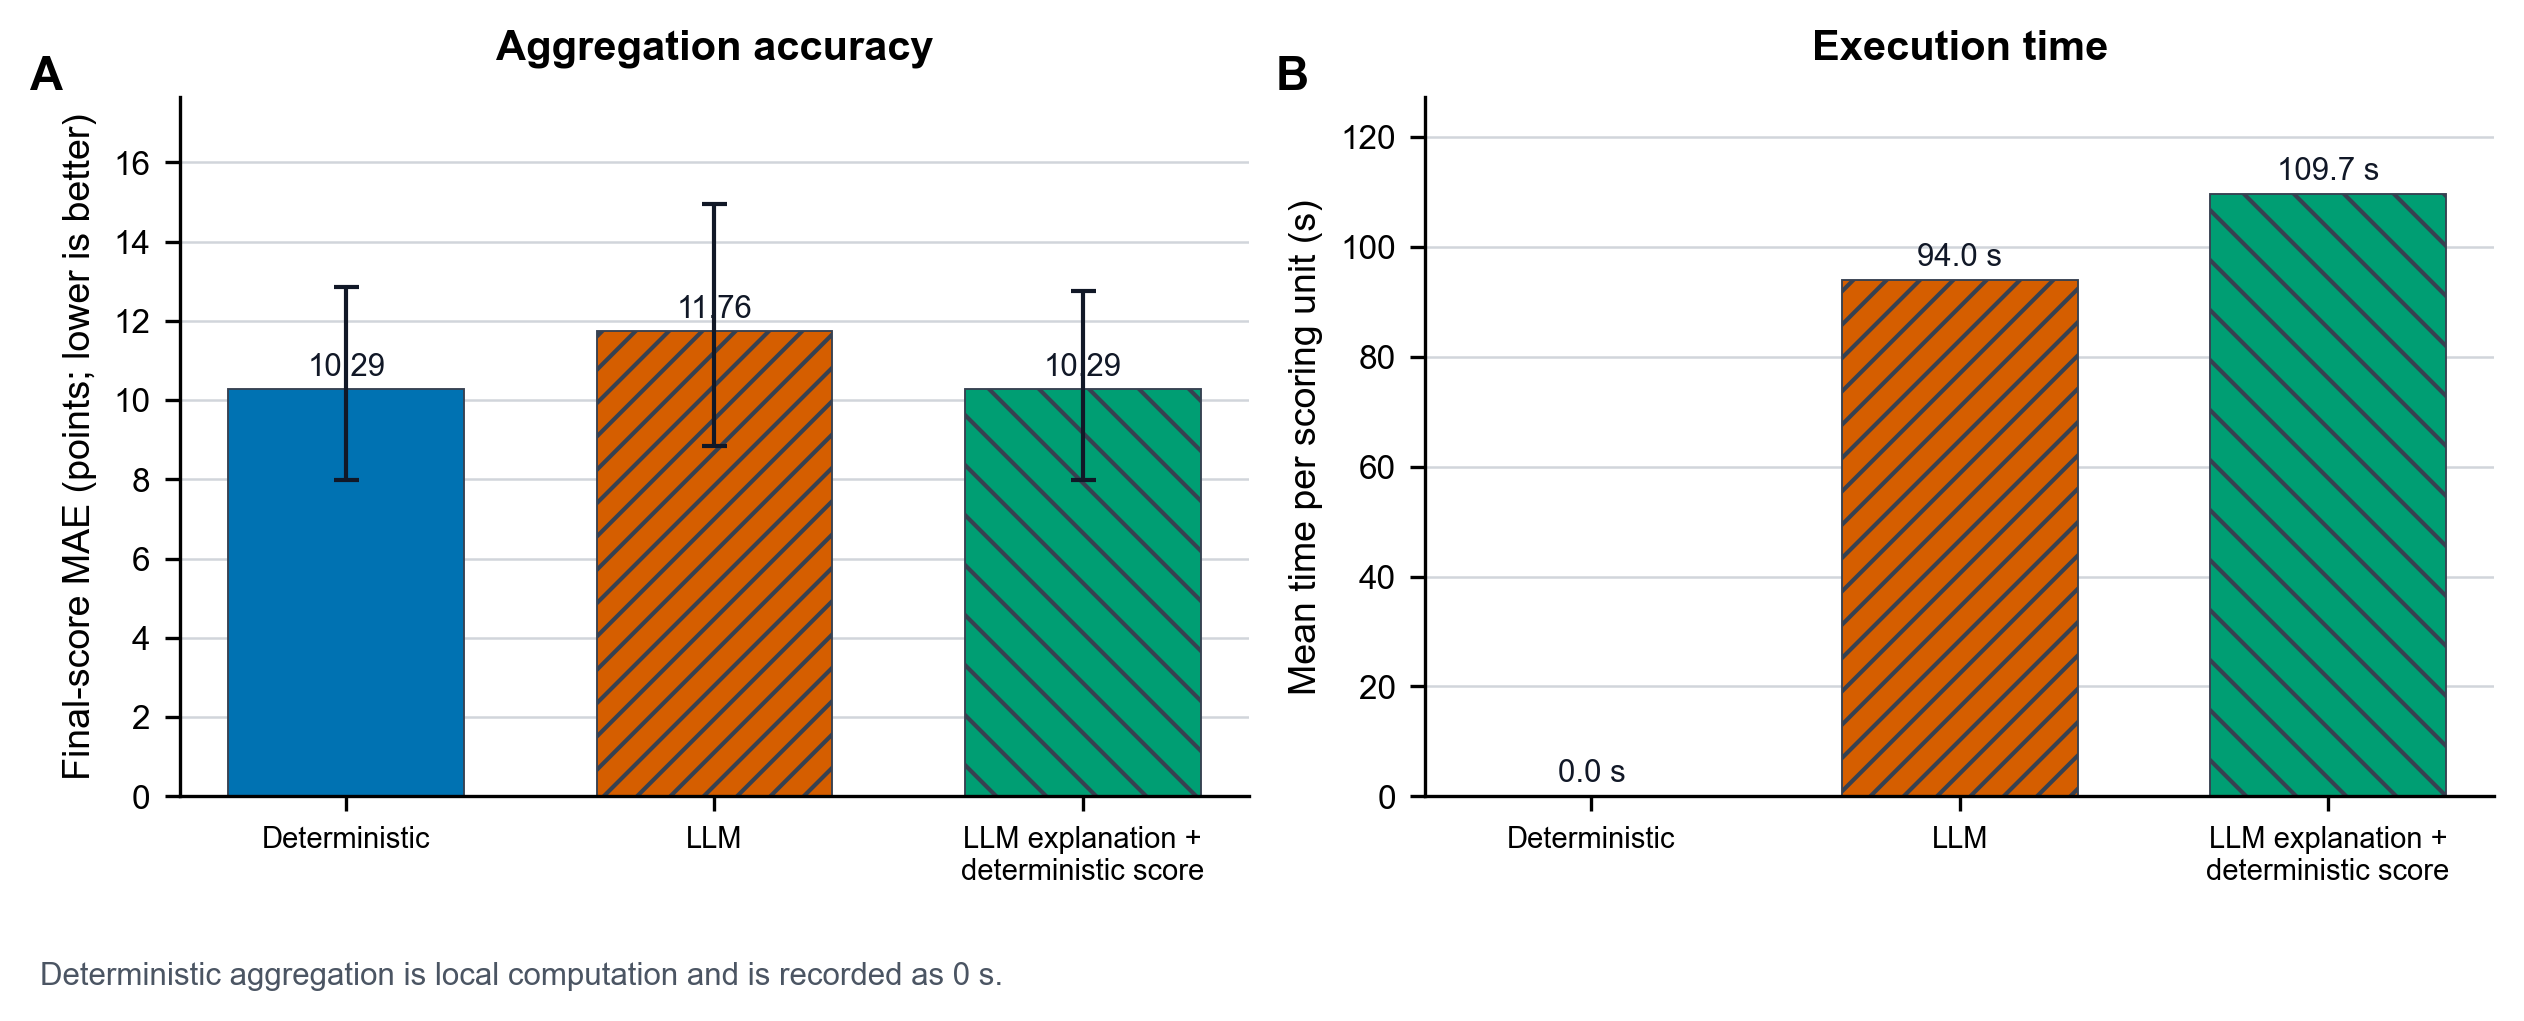
在冻结全部 criterion verdict 后,我们只改变最终分数的生成方式。固定公式的最终分数 MAE 为 10.29;LLM 自由聚合的 MAE 为 11.76,同时平均增加约 94 秒延迟。让 LLM 只生成解释、机器分数仍由固定公式计算时,机器分数与确定性方案完全一致,但平均增加约 110 秒延迟。
一旦 criterion verdict 已经确定,聚合的目标应是忠实执行权重、hard gate 和舍入规则,而不是再次进行语义判断。固定、版本化的公式能够被独立复算、单元测试和审计;LLM 在这一层没有显示准确率优势。
自然语言解释仍然有价值,但应与机器分数解耦。系统可以先同步返回确定性分数,再按需异步生成面向用户的解释,并确保解释无法反向修改分数。
更复杂的链路显著拉长运行时间
我们进一步审计了各配置产物中的运行遥测。证据路径保留了部分 wall-clock 时间:直接评分的中位耗时为 465 秒(四分位区间 386–603 秒);强制证据为 609 秒(505–753 秒);先抽证据再评分为 881 秒(806–995 秒)。由于部分证据链路的时间记录并不完整,这些数字只用于判断运行量级,不作为严格、无偏的速度排名。
聚合层的时间记录更完整:固定公式是本地计算,记录为近似 0 秒;LLM 聚合的中位耗时为 86.8 秒(69.9–108.0 秒),LLM 生成解释但保留固定分数为 106.1 秒(91.5–126.2 秒)。这与前面的结论一致:把 LLM 放进聚合链路会带来可观延迟,却没有获得更好的 Golden 对齐。
这些结果说明,证据约束与解释生成应按业务风险启用:证据路径带来的额外耗时用于换取更完整的审计链路;自然语言解释更适合异步生成;固定聚合则应继续保留在同步关键路径中。
面向生产的模块化设计
四组结果共同指向一个更清晰的架构:将“判断是否满足 rubric”“提供可核查证据”和“计算最终分数”拆成可独立验证的层。
| 系统层 | 默认设计 | 主要质量目标 |
|---|---|---|
| 判分层 | GPT-5.6-sol medium;rubric 每批 10 条 | Golden 对齐、稳定性、可控成本 |
| 审计层 | Judge 读取完整材料,并按需返回 evidence locator | 可追溯、可复核、可处理申诉 |
| 聚合层 | 固定、版本化公式计算 hard gate、维度分与总分 | 可复算、可测试、无隐藏漂移 |
落地时应保留四条工程护栏:
- 版本化 prompt、rubric 与聚合公式。 任一配置变化都应触发 Golden 回归。
- 分开监控准确率与审计率。 证据覆盖率高不等于分数更准,反之亦然。
- 按业务风险调整 batch size。 让调用成本服务于风险等级,而不是全局使用最贵配置。
- 将自然语言解释置于评分关键路径之外。 解释可以异步生成,但机器分数必须保持可复算。
适用边界与下一步
这些结论来自当前真实任务分布、固定 rubric 和同一 Golden 标准,仍需在更多任务类型与模型系列上复现。当前成本结论采用调用量代理与可验证延迟,适合比较配置之间的相对资源开销,不应直接解释为最终账单金额。独立 evidence ledger 的问题也需要通过人工标注证据召回率进一步定位。
下一阶段最重要的工作不是继续堆叠更复杂的 Judge 链路,而是扩大 Golden 回归集,在统一成本口径下持续评估不同配置的单位效果,并检查结论在新任务分布上的稳定性。
结语
可靠的 AI Judge 不是一个单点模型能力问题,而是一个系统设计问题。更高 effort、更多 LLM 步骤和更复杂的链路都可能增加成本,却不必然提高正确性。
更稳健的原则是:用 Golden 衡量准确性,用证据约束建立审计链路,用确定性公式完成聚合,再用成本和延迟决定哪些能力值得进入生产。
参考文献
- Zheng, L. et al. (2023). Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. NeurIPS 2023 Datasets and Benchmarks Track.
- Liu, Y. et al. (2023). G-Eval: NLG Evaluation using Gpt-4 with Better Human Alignment. EMNLP 2023.
- Wang, P. et al. (2024). Large Language Models are not Fair Evaluators. ACL 2024.
- Shi, L. et al. (2025). Judging the Judges: A Systematic Study of Position Bias in LLM-as-a-Judge. IJCNLP-AACL 2025.
- Xu, A. et al. (2025). Does Context Matter? ContextualJudgeBench for Evaluating LLM-based Judges in Contextual Settings. ACL 2025.