LeaderBoardTerminal-Bench 2.0 总榜
注:Oracle 是基于标准答案的理论满分(100%),作为对比标尺。即任务是明确可解的,模型分数低是因为终端执行、状态跟踪、自纠和 verifier 适配能力仍然不足。
核心领域基准评测
注:Oracle 是基于标准答案的理论满分(100%),作为对比标尺。即任务是明确可解的,模型分数低是因为终端执行、状态跟踪、自纠和 verifier 适配能力仍然不足。
Domain 分类占比
Sample Data
模型通过率 · PassRate@5(Terminus2 + model)
Gemini 3.1 Pro40%Claude 4.6 Opus20%GPT 5.40%GLM 50%DeepSeek-V3.20%Qwen3.5-Plus0%运行消耗 · Claude 4.6 Opus(Pass@5)
- 平均交互轮次
- 59.8
- 平均输入 Token
- 3,304,980
- 平均输出 Token
- 47,387
- 平均总消耗 Token
- 3,352,366
模型通过率 · PassRate@5(Terminus2 + model)
Claude 4.6 Opus60%Gemini 3.1 Pro40%GPT 5.420%GLM 50%DeepSeek-V3.20%Qwen3.5-Plus0%运行消耗 · Claude 4.6 Opus(Pass@5)
- 平均交互轮次
- 54.6
- 平均输入 Token
- 1,425,047
- 平均输出 Token
- 20,457
- 平均总消耗 Token
- 1,445,504
模型通过率 · PassRate@5(Terminus2 + model)
GPT 5.460%DeepSeek-V3.220%Claude 4.6 Opus0%Gemini 3.1 Pro0%GLM 50%Qwen3.5-Plus0%运行消耗 · Claude 4.6 Opus(Pass@5)
- 平均交互轮次
- 52.8
- 平均输入 Token
- 1,605,585
- 平均输出 Token
- 13,801
- 平均总消耗 Token
- 1,619,386
模型通过率 · PassRate@5(Terminus2 + model)
GPT 5.440%Claude 4.6 Opus0%Gemini 3.1 Pro0%DeepSeek-V3.20%Qwen3-Coder-480B0%运行消耗 · Claude 4.6 Opus(Pass@5)
- 平均交互轮次
- 32.0
- 平均输入 Token
- 873,935
- 平均输出 Token
- 21,631
- 平均总消耗 Token
- 895,566
补充材料
Passrate
PassRatePassRate@5 分桶分布
交互轮数(Turns)
Turns 是理解 long-horizon 与 multi-step 价值的关键指标。TB2.0 中的大量任务需要多轮执行、重试、定位、回归验证。
交互轮数分布
从轨迹分布看:
-
44.1%的成功轨迹需要20轮以上交互 -
59.7%的失败轨迹需要20轮以上交互 -
10.8%的成功轨迹需要40轮以上交互 -
19.3%的失败轨迹需要40轮以上交互
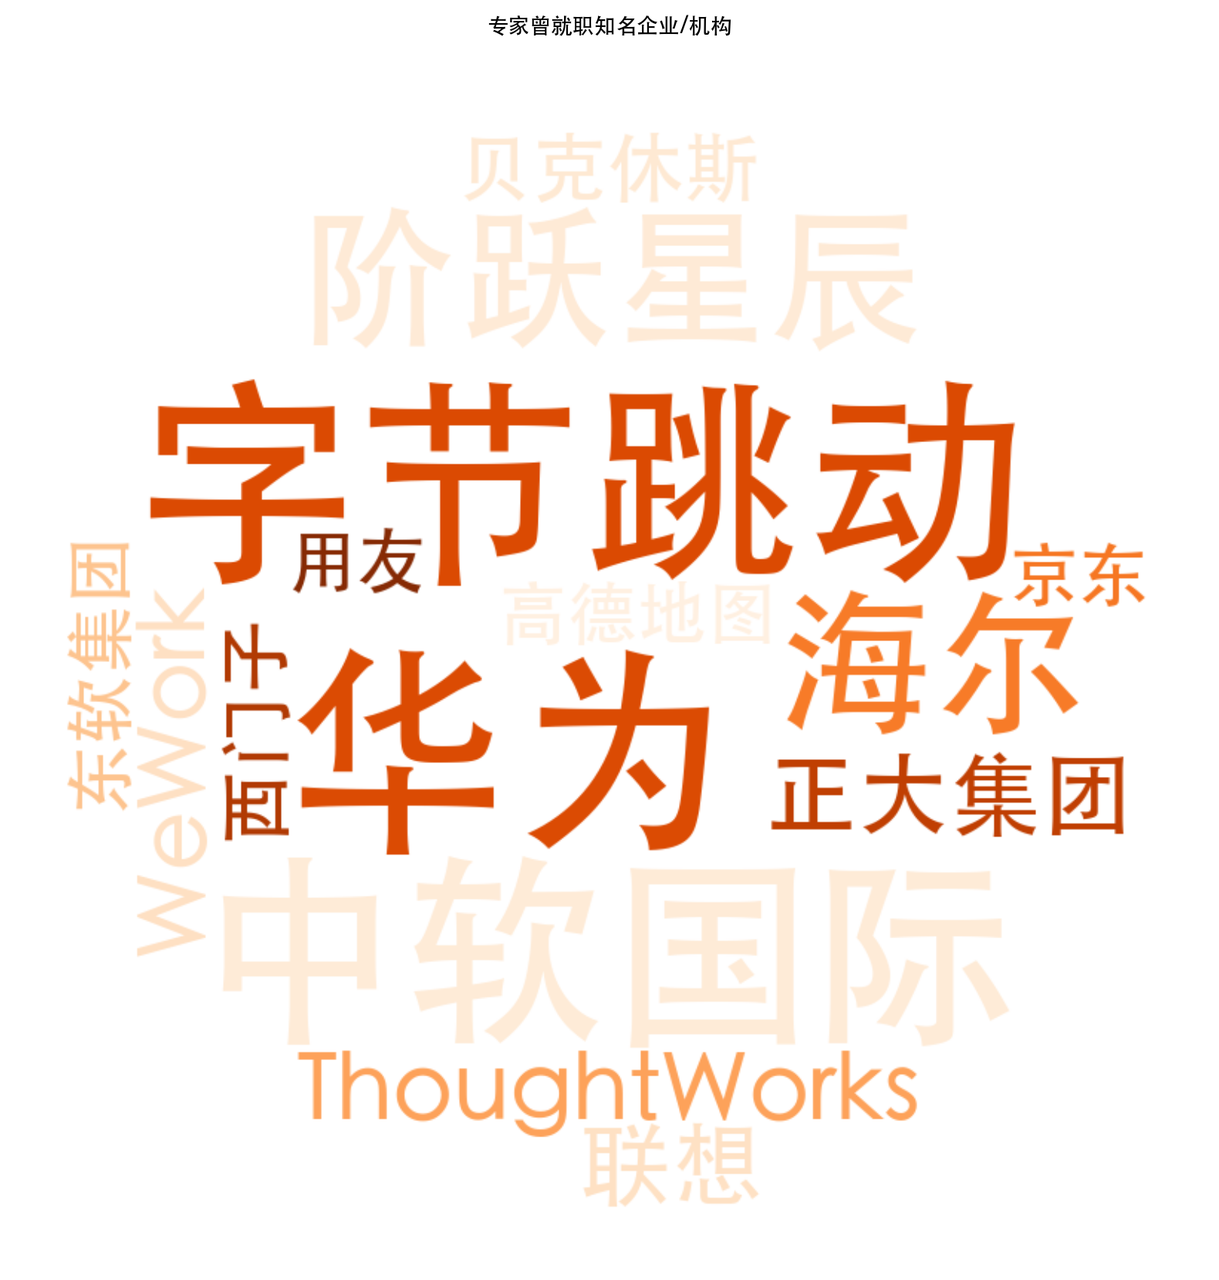
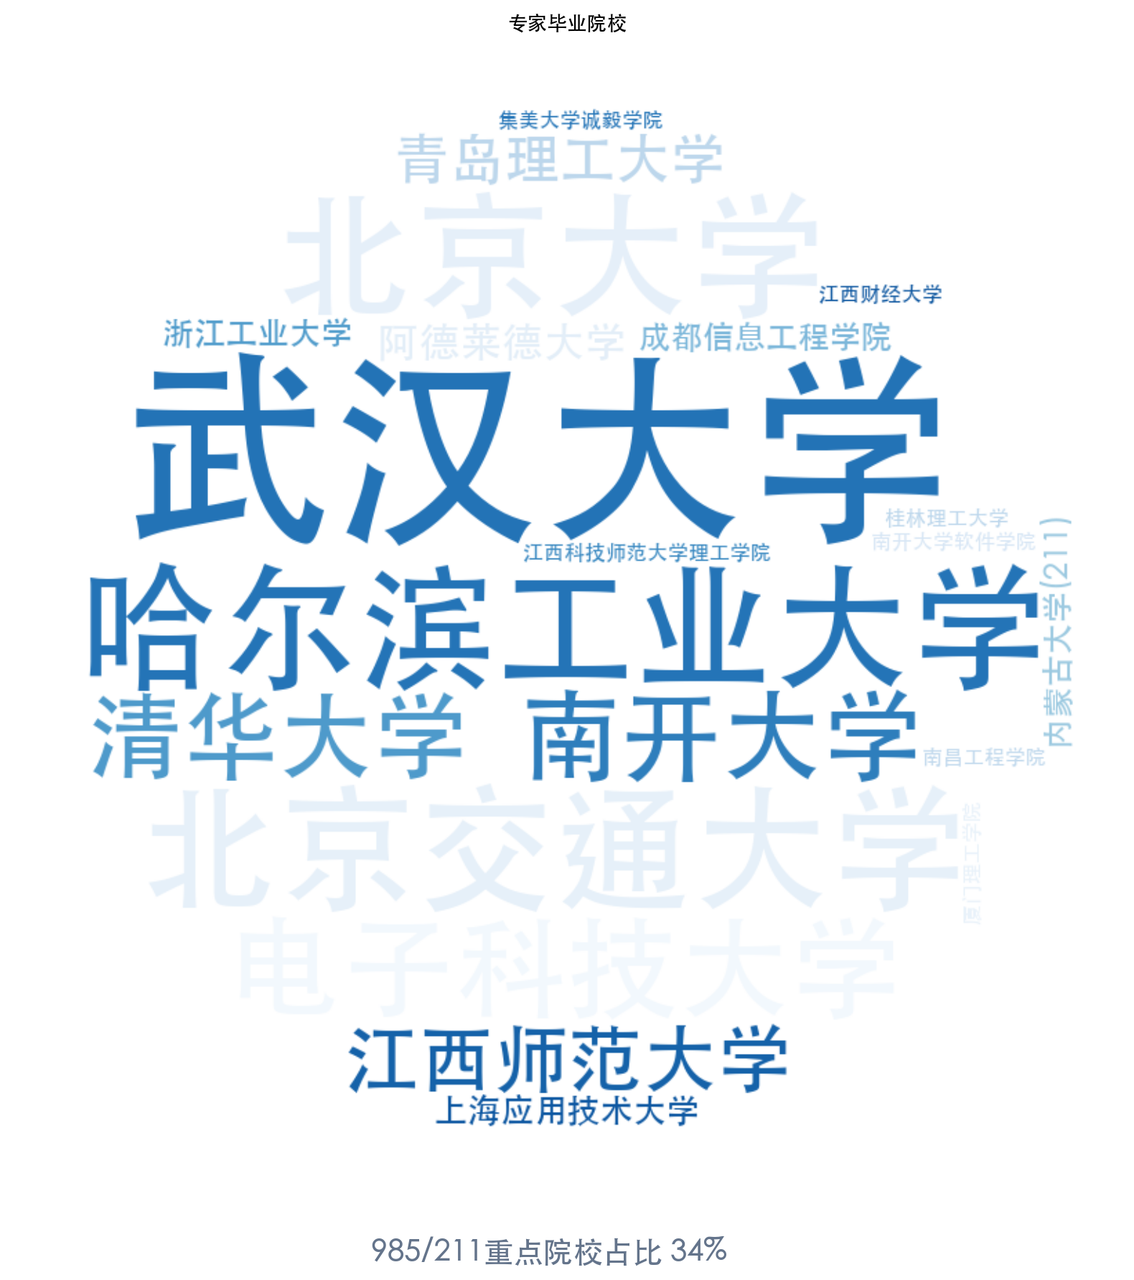
专家画像
核心技术能力覆盖率
专家工作年限分布
专家学历分布
生产流程
- 01任务设计与提交题面 / 环境 / 测试 / oracle / 标签
- 02预检与格式校验检查结构完整性、依赖声明、入口文件
- 03相似性与去重检查过滤近重复与低价值变体
- 04Valid & Oracle 验证在隔离环境中确认任务有解且可复现
- 05基线跑测 + 机审质检回填 pass rate / turns / logs,检查探索空间与环境稳定性
任务是否达到入审标准?
为保证 TB2.0 评测与训练数据的专业性、稳定性、可复现性与能力区分度,所有任务均由专家按统一规范设计,并经过自动化验证与多轮人工复审,形成标准化生产流程:
-
专家基于真实 terminal、coding、tool-use 与工程调试场景设计任务,严格控制任务难度、探索空间与多步复杂度,确保任务人工可稳定完成、模型具备明确提升空间;
-
采用统一任务结构与标准化任务包配置,完整包含题面、运行环境、测试脚本、参考解法(oracle)及必要元数据,保障任务可追溯、可复检、可批量调度;
-
指令仅描述目标、约束与交付标准,不直接暴露解题路径或中间策略,明确工具边界与环境限制,避免将任务退化为说明书式操作题;
-
基于隔离、可控、可复现的运行环境构建任务场景,尽可能消除外部网络依赖、随机波动与脆弱环境因素,保证 verifier 信号稳定可靠;
-
通过 Valid & Oracle 验证确认任务有解、可跑、可复现,并结合基线模型跑测回填 pass rate、执行轮数、失败分布等信号,对任务难度、long-horizon 特征与 multi-step 价值进行初筛;
-
结合相似性检查、机审质检与人工审核,对题面质量、测试覆盖、环境稳定性、奖励信号可信度及防作弊设计进行多维审查,过滤低价值、近重复或不可收敛任务。
数据控制
一面千识Terminal-Bench 2.0数据集致力于为 Outcome-based RL提供高质量的训练数据。我们的审核体系基于第一性原理设计,确保产出的每一条数据满足三大核心指标:任务高价值(具备探索空间)、奖励信号可信(测试公平精准)、运行结果稳定(100%可复现)。
一、 "五级漏斗"数据验证流程
我们构建了一套工业级的"机器自动化流水线 + 专家深度复核"的多级漏斗把控体系,确保数据纯净度:
入库前的五级验证漏斗
-
数据独特性检测 (Similarity Check):通过哈希去重、向量粗筛与语义精筛三层防线,防止训练集出现重复数据,保障数据多样性。
-
解法与环境验证 (Valid & Oracle):在隔离的 Docker 环境中自动运行参考解法(Solution),必须 100% 跑通所有测试用例,从源头确保题目在给定环境下绝对"可解"。
-
多维度静态质量审查 (Quality Assurance):审核专家介入审查 Prompt 清晰度、Prompt跟测试匹配度、工程实现规范及防作弊机制,确保没有泄露答案或包含不合理的外部依赖。
-
基于轨迹的动态深度诊断 (Log Analysis & Root Cause):根据SOTA模型运行的日志,逆向推导 Agent 表现与失败根因,排查极为隐蔽的测试逻辑漏洞。
-
难度兜底:运行Passrate@8(GLM4.7)量化题目难度,直接拦截通过率过高(≥0.625)的缺乏挑战性任务。
二、 严苛的三大核心数据标准
一面千识Terminal-Bench 2.0 对入库任务执行严苛的验收标准:
-
标准一:极高的探索空间
-
拒绝说明书式任务:严禁采用"按部就班"的指令或透题式提示词。优秀的任务必须像"解谜游戏"。
-
六维能力考量:通过路径复杂度、决策点数量、反馈循环等六大维度评估任务价值。模型必须通过真实的观察、推理与多轮试错才能获得成功,从而提供极高的 RL 训练价值。
-
-
标准二:恰到好处的测试设计
-
防误杀(防过严):严格校验测试用例,杜绝测试代码硬编码未要求的细节(如未规定的文件名、固定字符串格式等),确保兼容模型的等价正确解法。
-
防投机(防过松):防止测试用例只做表面检查(如仅验证文件存在而不查内容),要求覆盖题面约束的所有功能点与核心边界条件,保障 Reward(奖励信号)极度可信。
-
-
标准三:工业级的工程稳定性
-
环境零波动:强制禁止任务依赖外部网络(网络波动)、系统时间戳(Flaky 测试)以及未固定的随机数。
-
依赖强锁定:所有底层环境依赖项与工具链均使用官方稳定镜像源并实施严格的版本锁定,确保同一套解法无论运行多少次,都能获得完全一致的评分。
-