返回文章列表

RL Env: The Env Is the Easy Part

李宽野发布于2026年10月22日
返回文章列表

RL Env: The Env Is the Easy Part

李宽野发布于2026年10月22日

2026 年 8 月,Google 花 1000 万美元,在破产拍卖上拍下了 Spirit Airlines 留下的约 1 亿封邮件、5 亿条 Teams 消息和 3000 万行代码。[1] 一家航空公司倒闭后,连它的数据也被单独卖了出去。

这是 RL 环境这门生意里最容易看见的部分,也是最简单的部分。

买到一家公司的数据,不等于买到它的工作流。

说环境是 easy part,不是说它不难做。把一套开发环境容器化、做快照、并发跑几千个实例、保证每次结果一致,需要大量工程。但这类难题投入工程和算力就能推进,进展可以演示,可以量化。也正因为如此,这一层已经长出了 E2B、Daytona、Modal 这类专门提供沙箱和算力的 infra 公司。

另一类难题更非标,也更难量化:模型要学的真实工作流从哪来,什么才算把活干对,以及训练之后,模型到底有没有在真实工作里变好。

模型要的是工作流,环境只是载体

一个程序员的工作从来不只是改代码。读需求,翻历史讨论,改代码,跑本地测试,提交评审,等 CI,确认镜像发出去了,上线后盯监控,出了问题回滚。改代码只是其中一环。其他角色也一样:分析师不只是建模型,客服不只是回答问题。

模型要学的是这样一整条工作流:一个角色在一家公司里,怎么拿到信息,怎么做判断,怎么把一件事从开始做到交付。环境是承载这条工作流的载体。

过去两年,载体一直在变复杂。最早是单个系统:模型只需要在一个工具里把事做完。[2] 后来是多系统协作:模型要在代码托管、即时通讯、文档和项目管理之间来回切换,还要和模拟的同事沟通。[3] 下一阶段是整条业务链路:一件事从需求开始,跨过多个团队和系统,一直走到交付和上线运行。

这不是为了复杂而复杂。载体变复杂,是因为它要承载的工作流本来就横跨这些系统。载体需要追上工作流的复杂度。

工作流变复杂,变难的不只是环境。

task 越来越开放。最开始是执行:目标和信息都给齐了,照着做对就行。然后是判断:目标清楚,但要在多个决策点上自己选路。再往后是定义:连目标本身都要从交叉散落在工单、聊天记录和历史变更里的上下文中自己理清楚。

Easy:把退款审批的金额门槛从 500 元改成 1000 元。

Hard:最近客户老投诉退款慢,看一下

verifier 越来越难写。最开始判的是对错:有标准答案,一段脚本就能判。然后判的是经验:没有唯一答案,要靠行家判断做得好不好。再往后判的是品位:几种做法都成立,只有这一行里最顶尖的人,才分得出高下。
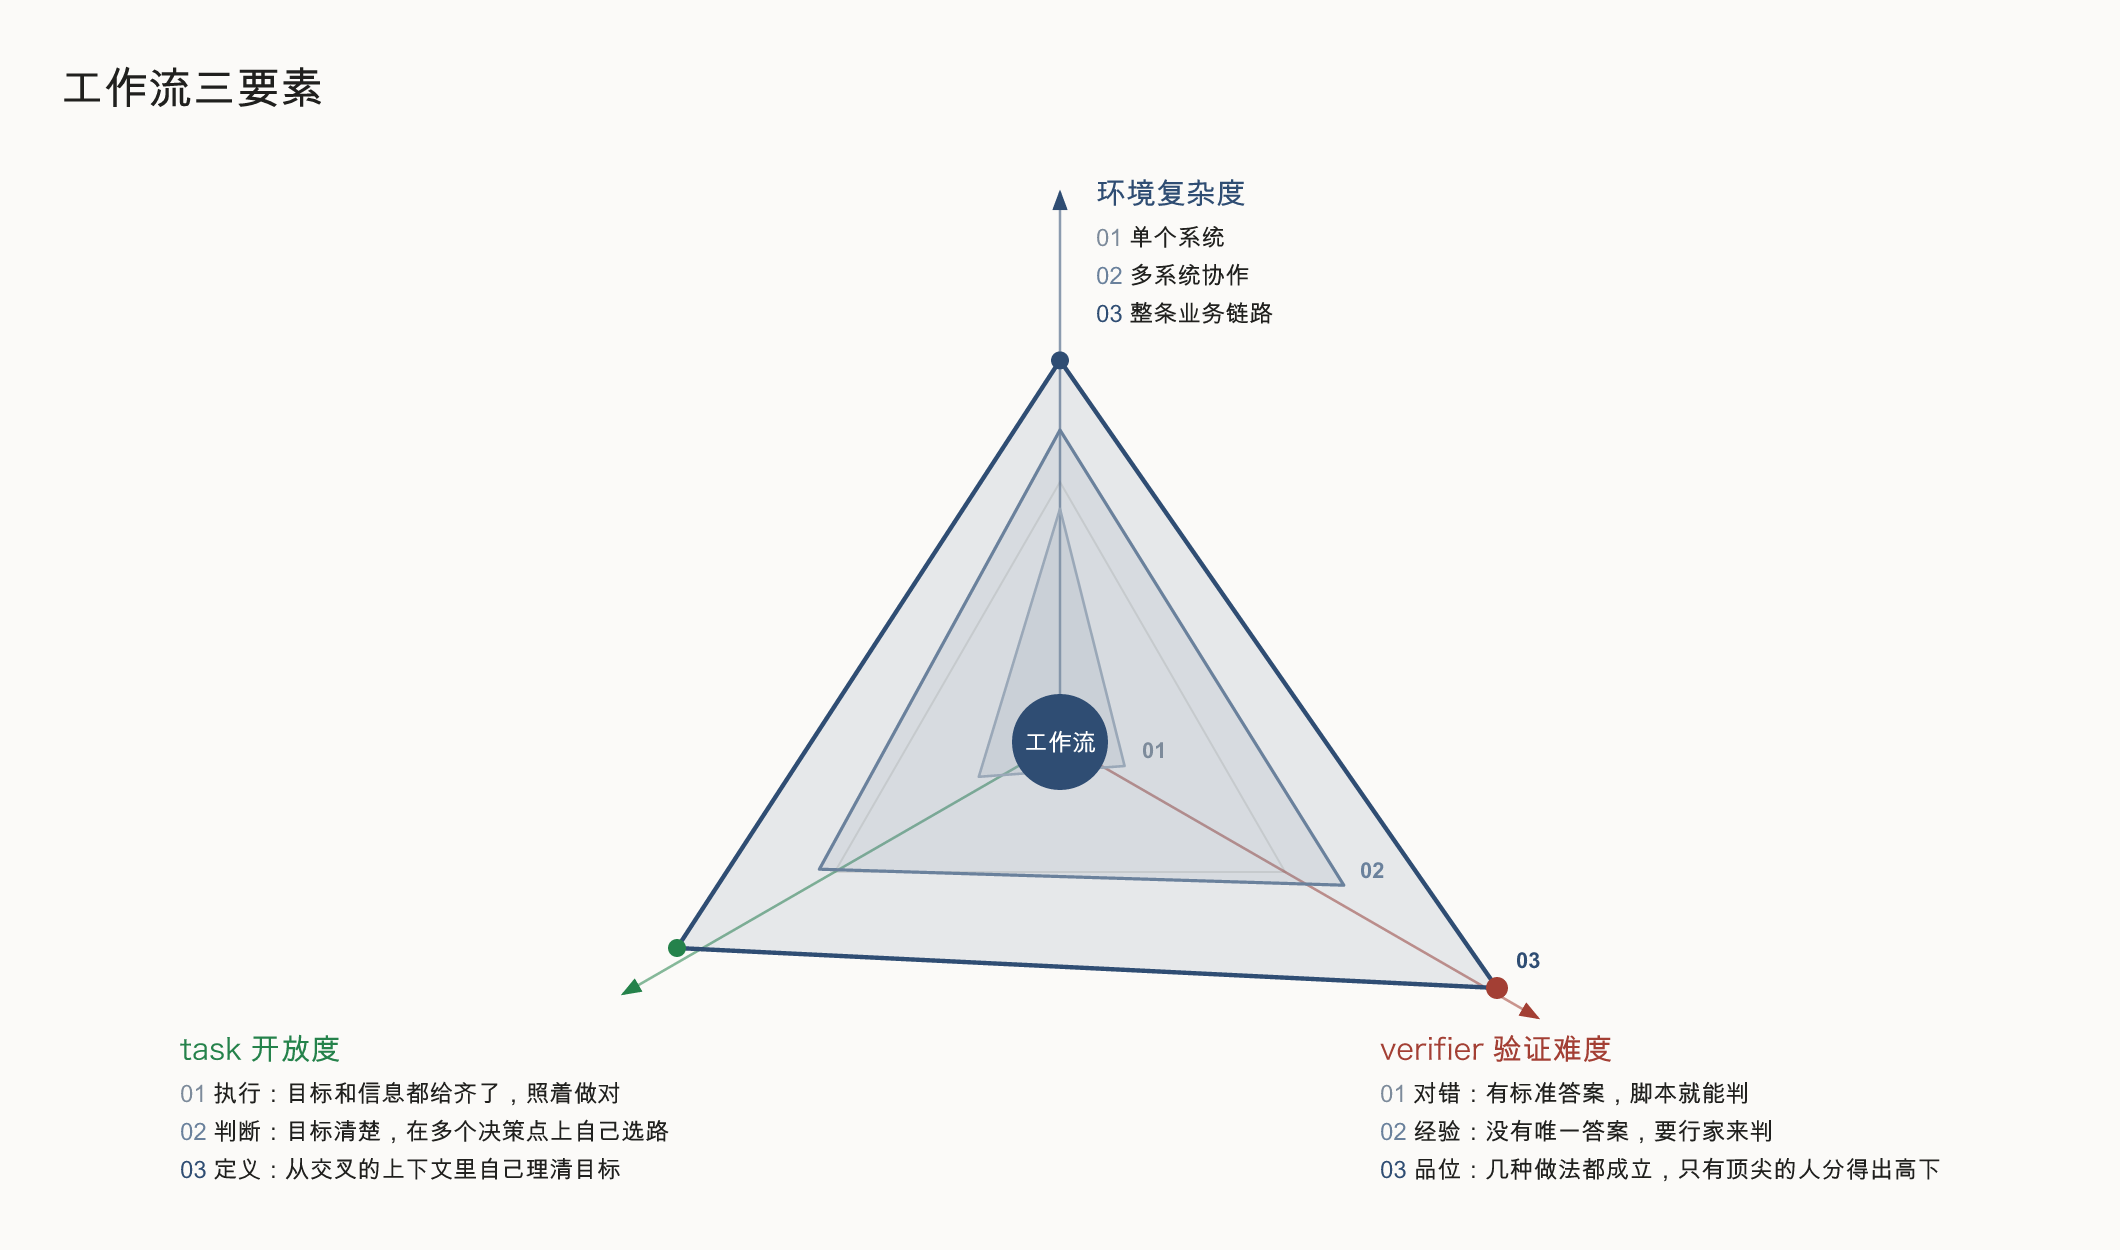
工作流三要素:环境复杂度、task 开放度与 verifier 验证难度
工作流三要素

三件事一起变难,但速度不一样。在单个系统阶段,最难的是环境:把一个陈年代码库跑起来、配好依赖,本身就是一项工程。工作流越往外扩,难点越往 task 和 verifier 转移。环境的三级都是工程问题,再复杂也能靠投入解决;task 和 verifier 走到第三级,"定义"和"品位"都只能靠人。

这就是为什么环境是 easy part。

RL Env = FDE + 可复现

FDE(Forward Deployed Engineer)是过去两年 AI 落地最常见的方式:工程师进驻客户现场,理解业务,把模型接进真实工作流。

RL Env 要做的事,和 FDE 有一半重合。两者都要理解客户的业务工作流:一个角色每天在做什么,哪些判断依赖上下文,什么情况算出事。

区别在另一半。FDE 不需要造环境,客户的系统本来就在运行,在线上把事情做成一次就够了。RL Env 要把这个活的工作流从客户现场搬出来,冻结成一个稳定可复现的环境,让模型在里面并行重放成千上万次,而且每一次的判定都稳定。

拆开看,RL Env 有三层。最底层是基础设施,负责 scaling 和可复现:容器、快照、并发、隔离。中间是业务环境的抽象与复现:业务实体、规则、角色、操作的后果。最上层是 task 和 verifier:由懂业务的人定义要做成什么,判断做没做对。
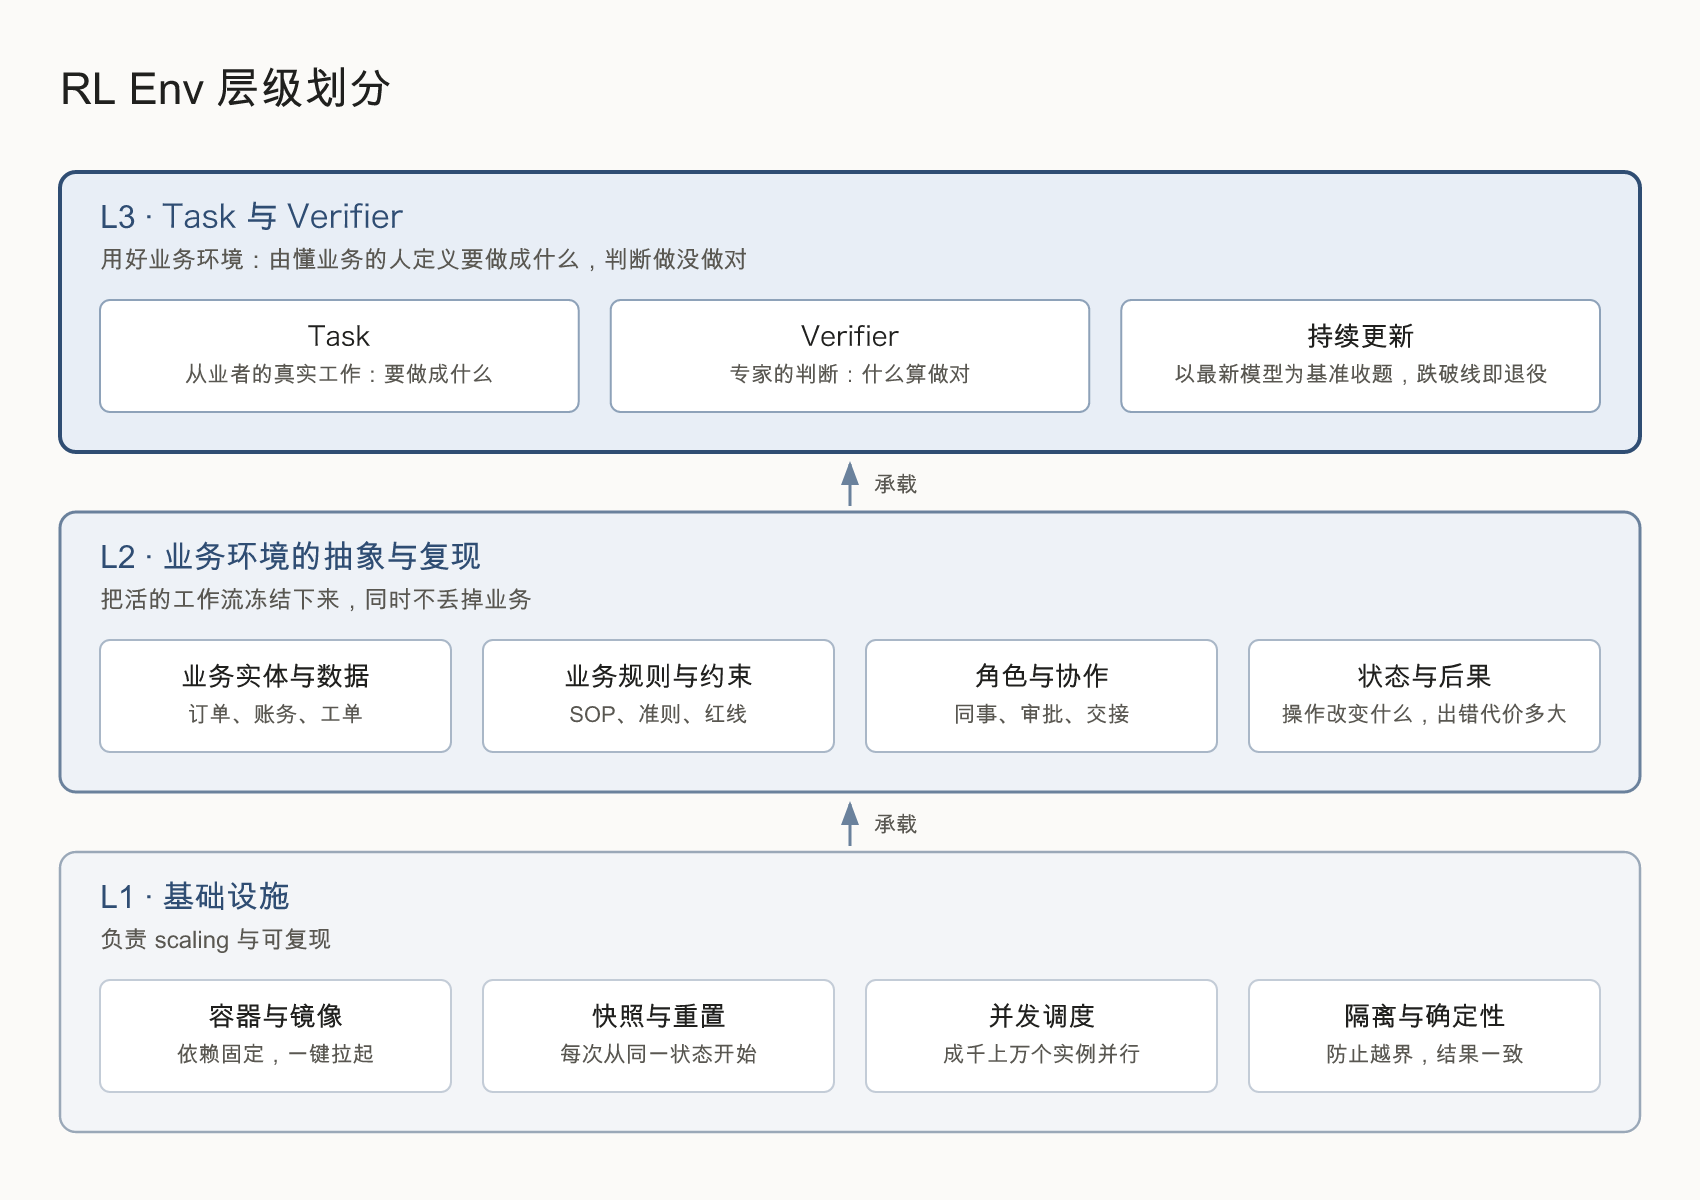
RL Env 层级划分:基础设施、业务环境的抽象与复现、Task 与 Verifier
RL Env 层级划分

基础设施这一层一直有人在做,也在稳步变成标准件,这是好事。

问题出在业务这一层。大家的注意力几乎都放在复刻业务环境上:收关停公司的数据,复刻它的 Slack、Jira 和代码库,在沙箱里重建业务实体和数据。这件事有价值,但它搭起来的只是舞台。

被忽略的是在舞台上工作的人:谁来说清楚一个任务真正要做成什么,谁来判断它做得对不对。

FDE 同样绕不开这个问题,这也是它商业模式里最难的一环:怎么证明工作流真的被优化了,效果能归因到自己身上。[4] 但 FDE 至少还有一个外部信号可以倒推:成本降了没有,周期短了没有,客户续不续约。这些信号很粗糙,但它们来自真实的业务,可以反过来校准什么是真需求、什么算做完。

RL Env 连这个信号也没有。工作流一旦从现场搬出来、冻结成环境,它的末端就不再连着任何真实的业务结果。一个 task 是不是真需求,一个 verifier 判得对不对,没有外部信号可以校准,只能取决于写它们的人。

这些人也没有跟着工作流一起被搬出来。环境可以复刻,人复刻不过来。一家关停公司的 Slack 记录了发生过什么,但已经没有人能告诉你,哪些决定是对的,哪次事故其实处理错了。SOP 和红线还能部分还原,"这个时候该怎么做"的判断,只存在于做这份工作的人脑子里。

没有这些人,复刻得再像的环境,也会退化成一个去掉了业务的通用版本:你能看到这家公司怎么运转,却不知道它为什么这样运转。

所以 RL Env 的关键不是再造一个环境,而是把人放回去:让从业者用真实的工作定义 task,让专家用真实的判断写 verifier。这是最非标、最难量化的部分。

环境只是三分之一

我们在收 task 和审 verifier 时,问题最多的恰恰也是 task 和 verifier。

OpenAI 也发现了这个问题。SWE-bench Verified 是它 2024 年推出的代码 benchmark,500 道题每道都经过三位资深工程师独立审查。2026 年,OpenAI 复盘了模型反复做不出的 138 道题,发现 59.4% 在测试设计或题目描述上有缺陷:35.5% 的测试过窄,绑定了具体的实现细节,把功能上正确的解判成错的;18.8% 的测试过宽,检查了题目里根本没提的功能。[5] 题目和 verifier 对不上,再强的模型也拿不到分。而找出这些问题,靠的是每道题至少六位资深工程师复审。

在评测里,这样的 verifier 只是让分数失真。在训练里,它会直接奖励错误的行为。

这还是来自真实 GitHub issue、经过专家审查的题目。市场上流行的另一种想法是:只要拿到一个足够复杂的环境,就可以在里面自己合成工作流,造出无限多的任务。

在 repo 之内,这条路走得通,因为测试本身就是现成的 verifier。工作流一旦跨出 repo,它就走不通了。一次变更该不该走紧急发布,一个告警该不该升级,一个需求做到什么程度算交付,这些判断由组织的上下文决定,不写在代码里。合成器看不到这些上下文,只能造出一个通用版本。合成的任务越多,离这家公司真实的工作流越远。

环境再复杂、任务再多,如果 task 和 verifier 背后没有真实的人,也只是在一个像公司的地方,大量生产像工作的东西。

不止 Code

Code 已经走完了第一阶段:单个 repo、单点修复这类任务,基本覆盖了绝大多数场景。现在它进入了下一个阶段:多系统协作,整条交付链路。

其他领域或早或晚会走上同一条路。财务、法律、咨询、客服,都有自己的工作流,也都会从单点任务走向跨系统、跨团队的链路。只是它们起步更晚,大多数还停在单点任务阶段,有些连单点任务都还没有被覆盖。

有一点会不一样:这些领域的 verifier 起点更高。它们大多没有可以运行的测试,没有"对错"这一级可以依赖,一开始就要靠经验来判。在这些领域,rubric 就是 verifier:把"什么算好"写成一组可以逐项检查的标准。难点同样不在判分的模型,而在 rubric 本身是否真的反映了专业判断。这是我们在 Rubric 系列里展开讨论的问题。

所以 Code 只是走的更快。Code 领域已经发生的事情,单点任务贬值,难点从环境转向 task 和 verifier,会在其他领域重演,而且 verifier 那一侧的难题会来得更早。

结尾

环境 Infra 会越来越成熟:标准化、可以按需购买。容器、快照、并发,会像今天的云计算一样,成为每家公司都能直接用上的基础能力。

到那时,RL 数据之间的差异不再来自环境,而来自环境里装着的东西:工作流是不是真的,task 有没有写对,判断是否可信,以及这一切能不能随着模型变强持续更新。

环境是 easy part。难的部分,一直是工作本身。

参考资料

  1. Google Paying $10 Million For Spirit Airlines’ Data To Train AI;Why Google Bid $10 Million for a Failed Airline’s Data
  2. SWE-bench: Can Language Models Resolve Real-World GitHub Issues?
  3. TheAgentCompany: Benchmarking LLM Agents on Consequential Real World Tasks;EnterpriseBench Corecraft
  4. Why most companies cannot measure their AI;Accenture and Workday Promise a Faster Path to Measurable AI Impact. The Path Has No Numbers on It.
  5. Why we no longer evaluate SWE-bench Verified

2026 年 8 月,Google 花 1000 万美元,在破产拍卖上拍下了 Spirit Airlines 留下的约 1 亿封邮件、5 亿条 Teams 消息和 3000 万行代码。[1] 一家航空公司倒闭后,连它的数据也被单独卖了出去。

这是 RL 环境这门生意里最容易看见的部分,也是最简单的部分。

买到一家公司的数据,不等于买到它的工作流。

说环境是 easy part,不是说它不难做。把一套开发环境容器化、做快照、并发跑几千个实例、保证每次结果一致,需要大量工程。但这类难题投入工程和算力就能推进,进展可以演示,可以量化。也正因为如此,这一层已经长出了 E2B、Daytona、Modal 这类专门提供沙箱和算力的 infra 公司。

另一类难题更非标,也更难量化:模型要学的真实工作流从哪来,什么才算把活干对,以及训练之后,模型到底有没有在真实工作里变好。

模型要的是工作流,环境只是载体

一个程序员的工作从来不只是改代码。读需求,翻历史讨论,改代码,跑本地测试,提交评审,等 CI,确认镜像发出去了,上线后盯监控,出了问题回滚。改代码只是其中一环。其他角色也一样:分析师不只是建模型,客服不只是回答问题。

模型要学的是这样一整条工作流:一个角色在一家公司里,怎么拿到信息,怎么做判断,怎么把一件事从开始做到交付。环境是承载这条工作流的载体。

过去两年,载体一直在变复杂。最早是单个系统:模型只需要在一个工具里把事做完。[2] 后来是多系统协作:模型要在代码托管、即时通讯、文档和项目管理之间来回切换,还要和模拟的同事沟通。[3] 下一阶段是整条业务链路:一件事从需求开始,跨过多个团队和系统,一直走到交付和上线运行。

这不是为了复杂而复杂。载体变复杂,是因为它要承载的工作流本来就横跨这些系统。载体需要追上工作流的复杂度。

工作流变复杂,变难的不只是环境。

task 越来越开放。最开始是执行:目标和信息都给齐了,照着做对就行。然后是判断:目标清楚,但要在多个决策点上自己选路。再往后是定义:连目标本身都要从交叉散落在工单、聊天记录和历史变更里的上下文中自己理清楚。

Easy:把退款审批的金额门槛从 500 元改成 1000 元。

Hard:最近客户老投诉退款慢,看一下

verifier 越来越难写。最开始判的是对错:有标准答案,一段脚本就能判。然后判的是经验:没有唯一答案,要靠行家判断做得好不好。再往后判的是品位:几种做法都成立,只有这一行里最顶尖的人,才分得出高下。

工作流三要素:环境复杂度、task 开放度与 verifier 验证难度
工作流三要素

三件事一起变难,但速度不一样。在单个系统阶段,最难的是环境:把一个陈年代码库跑起来、配好依赖,本身就是一项工程。工作流越往外扩,难点越往 task 和 verifier 转移。环境的三级都是工程问题,再复杂也能靠投入解决;task 和 verifier 走到第三级,"定义"和"品位"都只能靠人。

这就是为什么环境是 easy part。

RL Env = FDE + 可复现

FDE(Forward Deployed Engineer)是过去两年 AI 落地最常见的方式:工程师进驻客户现场,理解业务,把模型接进真实工作流。

RL Env 要做的事,和 FDE 有一半重合。两者都要理解客户的业务工作流:一个角色每天在做什么,哪些判断依赖上下文,什么情况算出事。

区别在另一半。FDE 不需要造环境,客户的系统本来就在运行,在线上把事情做成一次就够了。RL Env 要把这个活的工作流从客户现场搬出来,冻结成一个稳定可复现的环境,让模型在里面并行重放成千上万次,而且每一次的判定都稳定。

拆开看,RL Env 有三层。最底层是基础设施,负责 scaling 和可复现:容器、快照、并发、隔离。中间是业务环境的抽象与复现:业务实体、规则、角色、操作的后果。最上层是 task 和 verifier:由懂业务的人定义要做成什么,判断做没做对。

RL Env 层级划分:基础设施、业务环境的抽象与复现、Task 与 Verifier
RL Env 层级划分

基础设施这一层一直有人在做,也在稳步变成标准件,这是好事。

问题出在业务这一层。大家的注意力几乎都放在复刻业务环境上:收关停公司的数据,复刻它的 Slack、Jira 和代码库,在沙箱里重建业务实体和数据。这件事有价值,但它搭起来的只是舞台。

被忽略的是在舞台上工作的人:谁来说清楚一个任务真正要做成什么,谁来判断它做得对不对。

FDE 同样绕不开这个问题,这也是它商业模式里最难的一环:怎么证明工作流真的被优化了,效果能归因到自己身上。[4] 但 FDE 至少还有一个外部信号可以倒推:成本降了没有,周期短了没有,客户续不续约。这些信号很粗糙,但它们来自真实的业务,可以反过来校准什么是真需求、什么算做完。

RL Env 连这个信号也没有。工作流一旦从现场搬出来、冻结成环境,它的末端就不再连着任何真实的业务结果。一个 task 是不是真需求,一个 verifier 判得对不对,没有外部信号可以校准,只能取决于写它们的人。

这些人也没有跟着工作流一起被搬出来。环境可以复刻,人复刻不过来。一家关停公司的 Slack 记录了发生过什么,但已经没有人能告诉你,哪些决定是对的,哪次事故其实处理错了。SOP 和红线还能部分还原,"这个时候该怎么做"的判断,只存在于做这份工作的人脑子里。

没有这些人,复刻得再像的环境,也会退化成一个去掉了业务的通用版本:你能看到这家公司怎么运转,却不知道它为什么这样运转。

所以 RL Env 的关键不是再造一个环境,而是把人放回去:让从业者用真实的工作定义 task,让专家用真实的判断写 verifier。这是最非标、最难量化的部分。

环境只是三分之一

我们在收 task 和审 verifier 时,问题最多的恰恰也是 task 和 verifier。

OpenAI 也发现了这个问题。SWE-bench Verified 是它 2024 年推出的代码 benchmark,500 道题每道都经过三位资深工程师独立审查。2026 年,OpenAI 复盘了模型反复做不出的 138 道题,发现 59.4% 在测试设计或题目描述上有缺陷:35.5% 的测试过窄,绑定了具体的实现细节,把功能上正确的解判成错的;18.8% 的测试过宽,检查了题目里根本没提的功能。[5] 题目和 verifier 对不上,再强的模型也拿不到分。而找出这些问题,靠的是每道题至少六位资深工程师复审。

在评测里,这样的 verifier 只是让分数失真。在训练里,它会直接奖励错误的行为。

这还是来自真实 GitHub issue、经过专家审查的题目。市场上流行的另一种想法是:只要拿到一个足够复杂的环境,就可以在里面自己合成工作流,造出无限多的任务。

在 repo 之内,这条路走得通,因为测试本身就是现成的 verifier。工作流一旦跨出 repo,它就走不通了。一次变更该不该走紧急发布,一个告警该不该升级,一个需求做到什么程度算交付,这些判断由组织的上下文决定,不写在代码里。合成器看不到这些上下文,只能造出一个通用版本。合成的任务越多,离这家公司真实的工作流越远。

环境再复杂、任务再多,如果 task 和 verifier 背后没有真实的人,也只是在一个像公司的地方,大量生产像工作的东西。

不止 Code

Code 已经走完了第一阶段:单个 repo、单点修复这类任务,基本覆盖了绝大多数场景。现在它进入了下一个阶段:多系统协作,整条交付链路。

其他领域或早或晚会走上同一条路。财务、法律、咨询、客服,都有自己的工作流,也都会从单点任务走向跨系统、跨团队的链路。只是它们起步更晚,大多数还停在单点任务阶段,有些连单点任务都还没有被覆盖。

有一点会不一样:这些领域的 verifier 起点更高。它们大多没有可以运行的测试,没有"对错"这一级可以依赖,一开始就要靠经验来判。在这些领域,rubric 就是 verifier:把"什么算好"写成一组可以逐项检查的标准。难点同样不在判分的模型,而在 rubric 本身是否真的反映了专业判断。这是我们在 Rubric 系列里展开讨论的问题。

所以 Code 只是走的更快。Code 领域已经发生的事情,单点任务贬值,难点从环境转向 task 和 verifier,会在其他领域重演,而且 verifier 那一侧的难题会来得更早。

结尾

环境 Infra 会越来越成熟:标准化、可以按需购买。容器、快照、并发,会像今天的云计算一样,成为每家公司都能直接用上的基础能力。

到那时,RL 数据之间的差异不再来自环境,而来自环境里装着的东西:工作流是不是真的,task 有没有写对,判断是否可信,以及这一切能不能随着模型变强持续更新。

环境是 easy part。难的部分,一直是工作本身。

参考资料

  1. Google Paying $10 Million For Spirit Airlines’ Data To Train AI;Why Google Bid $10 Million for a Failed Airline’s Data
  2. SWE-bench: Can Language Models Resolve Real-World GitHub Issues?
  3. TheAgentCompany: Benchmarking LLM Agents on Consequential Real World Tasks;EnterpriseBench Corecraft
  4. Why most companies cannot measure their AI;Accenture and Workday Promise a Faster Path to Measurable AI Impact. The Path Has No Numbers on It.
  5. Why we no longer evaluate SWE-bench Verified
返回

更多博客